IA sur la machine
Le moteur d'IA local, accéléré en Vulkan sur le GPU de la BC-250 — Unsloth Studio, avec des modèles GGUF venus de Hugging Face.
SkillFishOS embarque une IA locale : des modèles de discussion et de programmation qui tournent entièrement sur le GPU de la BC-250, sans nuage, sans rien envoyer dehors. Un clic l’allume et l’éteint, si bien que le GPU et la mémoire redeviennent libres quand vous voulez jouer.
Pourquoi Vulkan et pas ROCm
La pile de calcul « officielle » d’AMD est ROCm, mais elle ne prend pas en charge le gfx1013 de la BC-250. SkillFishOS utilise donc le moteur Vulkan avec les pilotes Mesa/RADV : il exploite pleinement le GPU intégré et la mémoire partagée (avec le GTT agrandi, voir GPU).
Ce que cela change. Mesuré sur la carte avec Qwen3-1.7B Q4_K_M :
| CPU seul | GPU par Vulkan | ||
|---|---|---|---|
| Génération | 41,5 jetons/s | 210,7 jetons/s | 5,1× |
| Traitement de l’invite | 9,2 jetons/s | 157,2 jetons/s | 17× |
Le moteur : Unsloth Studio
Depuis la 26.08 le moteur est Unsloth Studio, à la place de l’ancien assemblage Docker Ollama + OpenWebUI. C’est un seul service natif qui fournit à la fois l’interface de discussion et une interface compatible OpenAI, à l’écoute sur 127.0.0.1:8888.
Ce qui change en pratique :
- Un service au lieu d’un assemblage Docker. Il fallait avant trois conteneurs (Ollama, OpenWebUI, Dockge) plus une image sur mesure d’environ 6,5 Go ; maintenant c’est juste
skillfish-unsloth.service. - Les modèles viennent de Hugging Face. Unsloth récupère les fichiers GGUF directement dans tout le catalogue Hugging Face plutôt que dans un registre restreint, si bien que le choix de modèles et de quantifications est bien plus large — y compris les versions que l’équipe Unsloth publie elle-même.
- De lui-même il ne répond qu’à la machine. De l’extérieur on l’atteint par le Remote Manager, qui vérifie les comptes par PAM. Si vous voulez que les autres appareils de la maison s’en servent aussi, la section IA a un interrupteur qui l’ouvre au réseau local, avec son propre compte et son propre mot de passe.
Les modèles
Les modèles sont des fichiers GGUF du catalogue Hugging Face, et ils arrivent de deux endroits : la section IA du Control Center, où tu écris le nom du dépôt (par exemple unsloth/Qwen3-4B-GGUF) et choisis la variante dans la liste, tailles comprises ; ou le Hub dans Unsloth Studio, qui a la recherche et les fiches complètes.
Règle pratique sur cette carte : les 16 Go de GDDR6 sont partagés entre le système et le GPU, donc mieux vaut rester sous ~11 Go de poids pour laisser de l’air au reste.
Allumage, mise à jour et clé
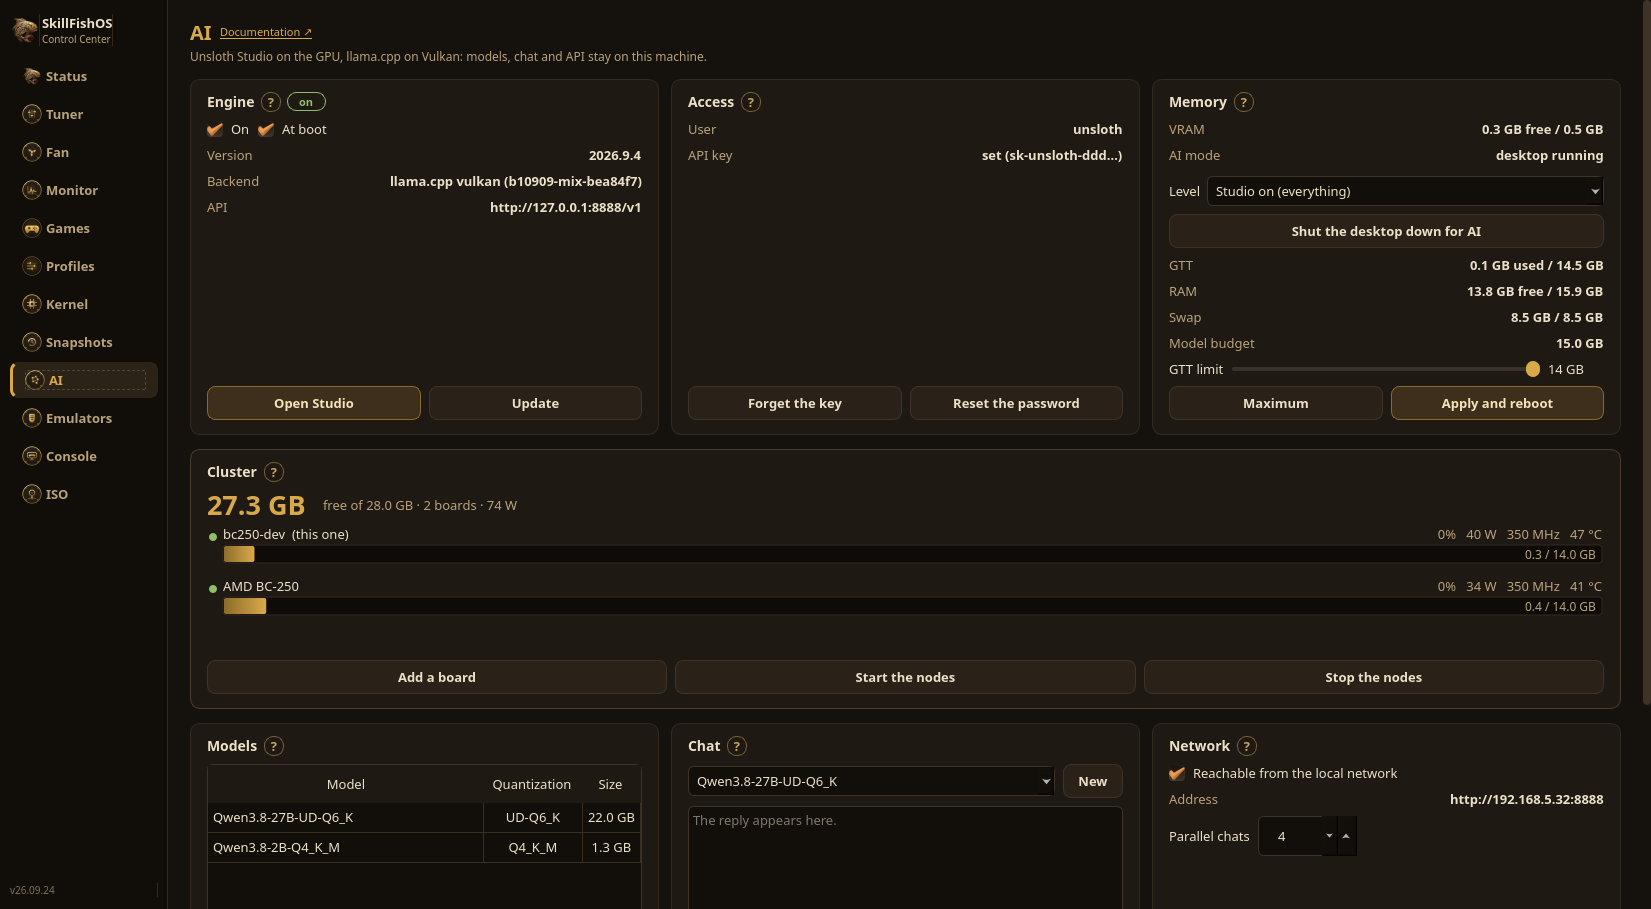
La section IA du Control Center allume et éteint le moteur, l’active au démarrage et affiche la version avec la mise à jour en un clic. La même chose se trouve dans le Remote Manager, depuis le navigateur.
Unsloth génère un mot de passe au hasard à l’installation, et s’éteint tout seul au bout d’une heure s’il n’est pas changé. Cette étape, la section IA la fait : tu choisis le mot de passe de Studio et la clé API est créée en même temps. La clé est le moyen pour la fenêtre et le Remote Manager de parler au moteur ; les modèles sur le disque, la mémoire (VRAM, GTT, RAM, swap) et un essai de chat avec les tokens par seconde mesurés sont juste à côté.
Garde en tête que :
- IA et jeux ne vont pas ensemble : ils partagent le même GPU et la même mémoire ;
- moteur éteint, le GPU et la RAM redeviennent entièrement disponibles pour le jeu.
Donner plus de mémoire au modèle
Le bureau occupe de la mémoire dont le modèle pourrait se servir. La section IA l’éteint, et permet aussi de choisir jusqu’où : Studio allumé, c’est-à-dire le bureau seul ; le moteur seul, avec la page web ; le moteur seul, l’interface seule, ce qui laisse llama-server tout seul sur le port 8888, avec la même interface et la même clé qu’avant. Mesuré sur une carte avec un modèle chargé : 567 Mo de mémoire système deviennent 115.
À partir de là on pilote la machine depuis le Remote Manager d’un autre ordinateur, ou par ssh. Le modèle du moteur nu se choisit avant, dans la même carte.
Plus d’une carte
Plusieurs cartes BC-250 se partagent un modèle trop grand pour une seule. La carte Cluster énumère les cartes, la mémoire dont elles disposent ensemble et ce qu’elles consomment, et allume et éteint les nœuds. Un 27B de 22 Go ne se charge même pas sur une seule carte ; sur deux, il tourne à 7,57 jetons par seconde.
C’est à cela qu’il sert, et autant le dire clairement : ce n’est pas plus rapide. Un modèle qui tenait sur une carte perd environ un tiers de sa vitesse une fois réparti, car chaque frontière entre couches passe par le réseau. La grappe est faite pour les modèles qui, seuls, ne tournent pas du tout.
Sources
- Unsloth · llama.cpp · Hugging Face
- Mesa / RADV (le pilote Vulkan)
- ROCm — matériel pris en charge (
gfx1013n’y figure pas)