AI in locale
Il motore AI locale accelerato in Vulkan sulla GPU della BC-250 — Unsloth Studio, con i modelli GGUF di Hugging Face.
SkillFishOS include uno stack di intelligenza artificiale locale: modelli di chat e coding che girano interamente sulla GPU della BC-250, senza cloud e senza inviare dati all’esterno. Si accende e spegne con un clic, così da liberare GPU e RAM quando vuoi giocare.
Perché Vulkan e non ROCm
Lo stack AMD “ufficiale” per il calcolo è ROCm, ma non supporta la gfx1013 della BC-250. SkillFishOS usa quindi il backend Vulkan con i driver Mesa/RADV: sfrutta la GPU integrata e la memoria condivisa (col GTT esteso, vedi GPU).
Quanto conta. Misurato sulla scheda con Qwen3-1.7B Q4_K_M:
| solo CPU | GPU via Vulkan | ||
|---|---|---|---|
| Generazione | 41,5 tok/s | 210,7 tok/s | 5,1× |
| Elaborazione del prompt | 9,2 tok/s | 157,2 tok/s | 17× |
Il motore: Unsloth Studio
Dalla versione 26.08 il motore è Unsloth Studio, che sostituisce il precedente stack Ollama + OpenWebUI in Docker. È un servizio nativo unico che offre insieme l’interfaccia di chat e un’API compatibile OpenAI, in ascolto su 127.0.0.1:8888.
Cosa cambia in pratica:
- Un servizio invece di uno stack Docker. Prima servivano tre container (Ollama, OpenWebUI, Dockge) e un’immagine custom da ~6,5 GB; ora c’è
skillfish-unsloth.servicee basta. - I modelli sono quelli di Hugging Face. Unsloth scarica direttamente i GGUF dal catalogo completo di Hugging Face, invece di un registro curato: la scelta di modelli e di quantizzazioni disponibili è enormemente più ampia, comprese le build che il team Unsloth pubblica per conto proprio.
- Di suo ascolta solo la macchina stessa. Da fuori ci si arriva attraverso il Remote Manager, che autentica via PAM. Se vuoi che risponda anche agli altri dispositivi di casa, nella sezione AI c’è un interruttore che lo apre alla rete locale, con il suo utente e la sua password.
I modelli
I modelli sono file GGUF del catalogo di Hugging Face, e si scaricano da due posti: dalla sezione AI del Control Center, scrivendo il nome del repository (per esempio unsloth/Qwen3-4B-GGUF) e scegliendo la variante dall’elenco, che riporta le dimensioni; oppure dall’Hub dentro Unsloth Studio, che ha la ricerca e le schede complete.
Regola pratica su questa scheda: i 16 GB di GDDR6 sono condivisi tra sistema e GPU, quindi conviene stare sotto gli ~11 GB di pesi per lasciare respiro al resto.
Accensione, aggiornamento e chiave
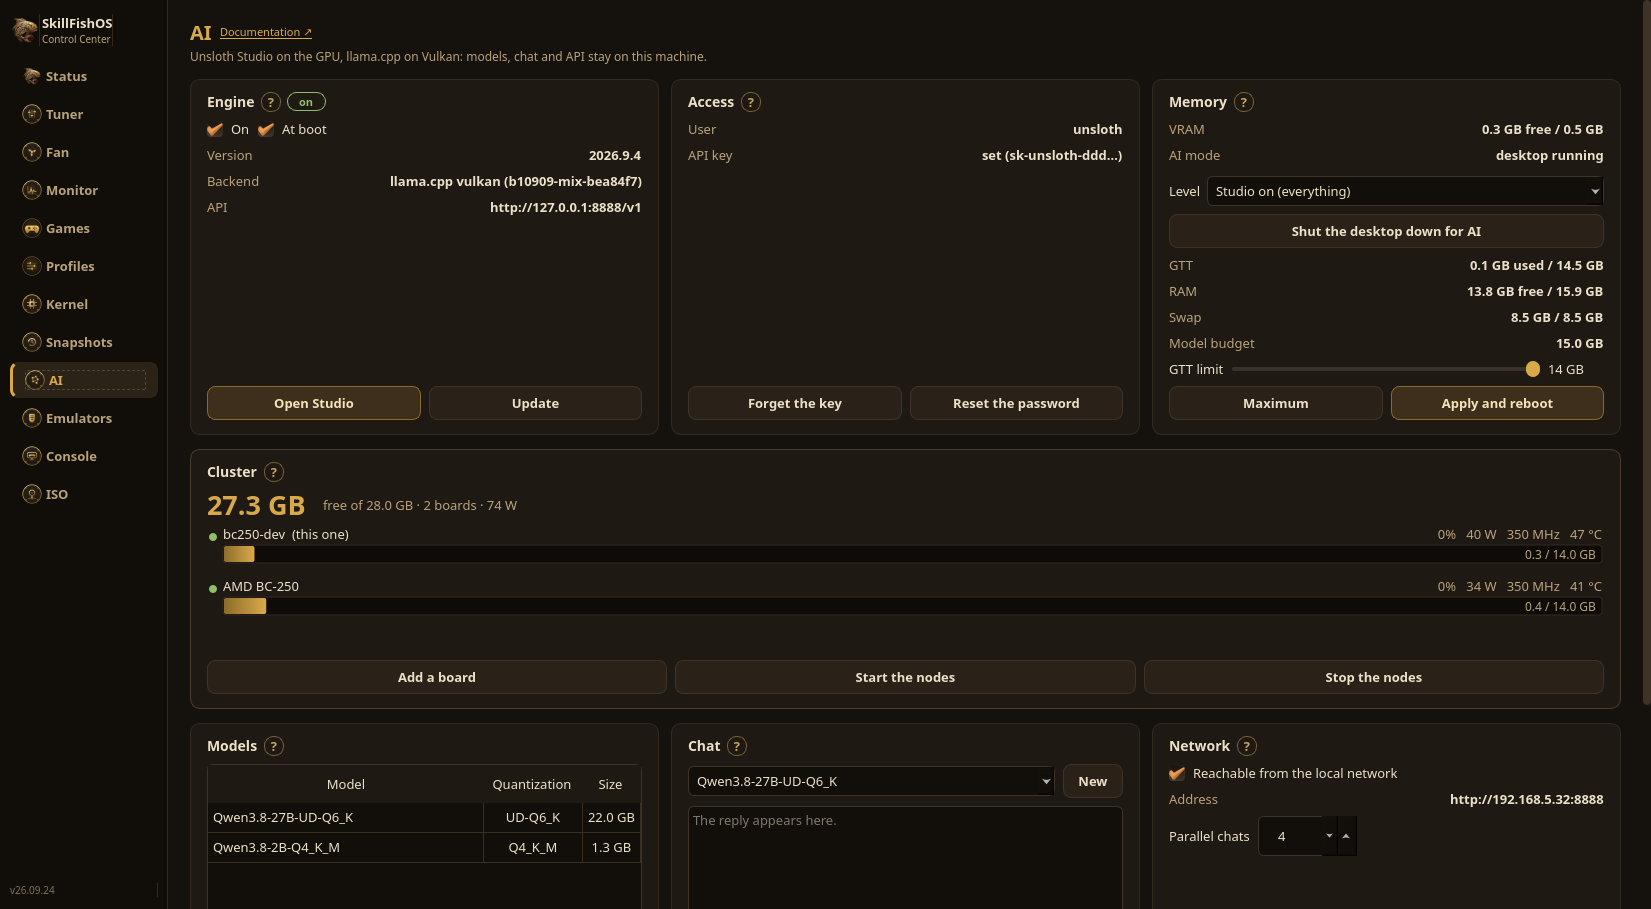
La sezione AI del Control Center accende e spegne il motore, lo abilita all’avvio e mostra la versione con l’aggiornamento in un clic. Lo stesso c’è nel Remote Manager, dal browser.
Unsloth genera una password a caso quando si installa, e si spegne da solo dopo un’ora se non viene cambiata. Quel passaggio lo fa la sezione AI: scegli la password di Studio e la chiave API viene creata insieme. La chiave serve alla finestra e al Remote Manager per parlare col motore; i modelli sul disco, la memoria (VRAM, GTT, RAM, swap) e una prova di chat con i token al secondo misurati stanno lì accanto.
Tieni presente che:
- AI e giochi non vanno usati insieme: condividono la stessa GPU e la stessa memoria;
- a motore spento, GPU e RAM tornano completamente disponibili per il gaming.
Dare più memoria al modello
Il desktop occupa memoria che il modello potrebbe usare. Dalla sezione AI lo si spegne, e si sceglie anche quanto spegnere: Studio acceso, cioè solo il desktop; solo il motore, con pagina web; solo il motore, solo API, che lascia llama-server da solo sulla porta 8888, con la stessa API e la stessa chiave di prima. Misurato su una scheda con il modello caricato: 567 MB di memoria di sistema diventano 115.
Da lì in poi la macchina si comanda dal Remote Manager di un altro computer, o da ssh. Il modello del motore nudo si sceglie prima, nella stessa scheda.
Più di una scheda
Più BC-250 si dividono un modello troppo grande per una sola. La scheda Cluster elenca le schede, quanta memoria hanno insieme e quanto stanno assorbendo, e accende e spegne i nodi. Un 27B da 22 GB su una scheda non si carica nemmeno; su due gira a 7,57 token al secondo.
Serve a questo, e conviene dirlo chiaro: non va più veloce. Un modello che su una scheda ci stava perde circa un terzo della sua velocità quando lo si divide, perché ogni confine fra strati viaggia sulla rete. Il cluster è per i modelli che da soli non girano.
Fonti
- Unsloth · llama.cpp · Hugging Face
- Mesa / RADV (driver Vulkan)
- ROCm — hardware supportato (la
gfx1013non è in elenco)